前言 #
翻译页面对比 #
下面的图片是我使用 PDFMathTranslate + Ollama 完全使用本地服务跑出来的效果⬇️
样例1:
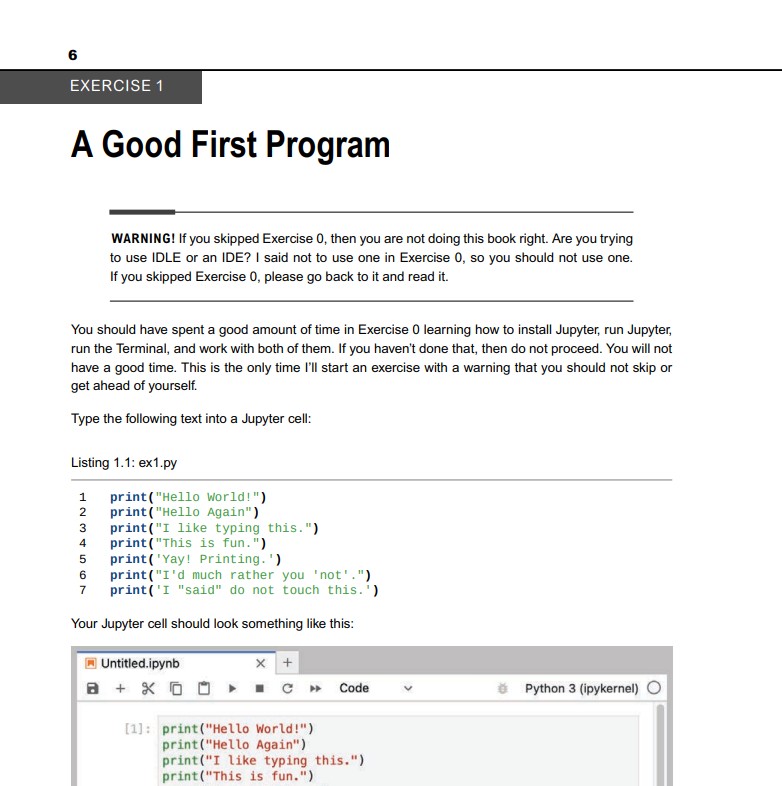
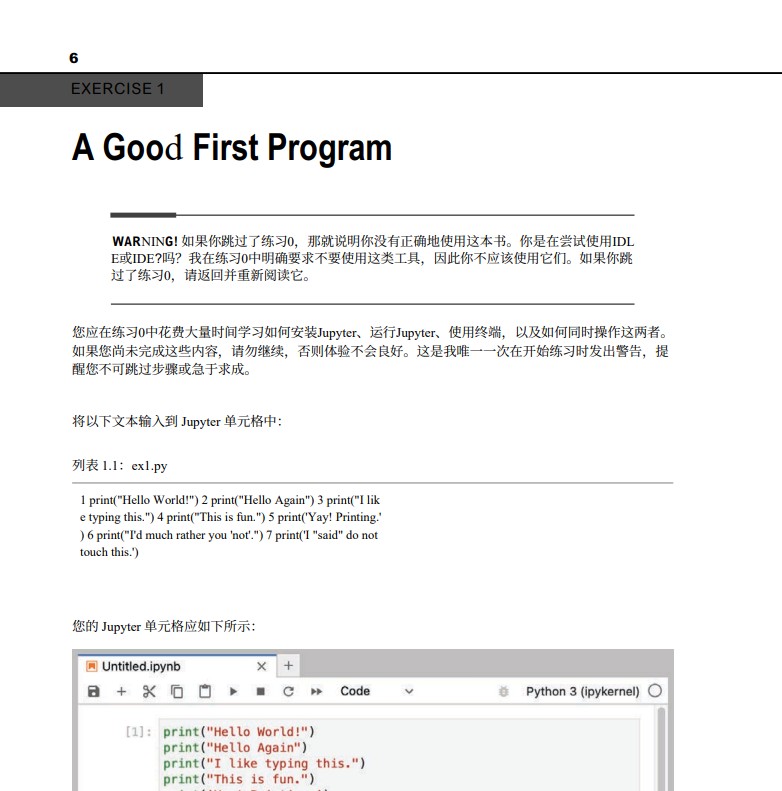
书本格式的不同,翻译出来的效果也会不同。
就像上图里代码内容排版被强制破坏,有时还会被翻译成不伦不类的内容…
有类似代码、公式的内容,最好还是阅读原文+译文的合并版输出文件
我暂时没有找到很好的调整方法,有能力的朋友可以自己试着钻研一下。
样例2:
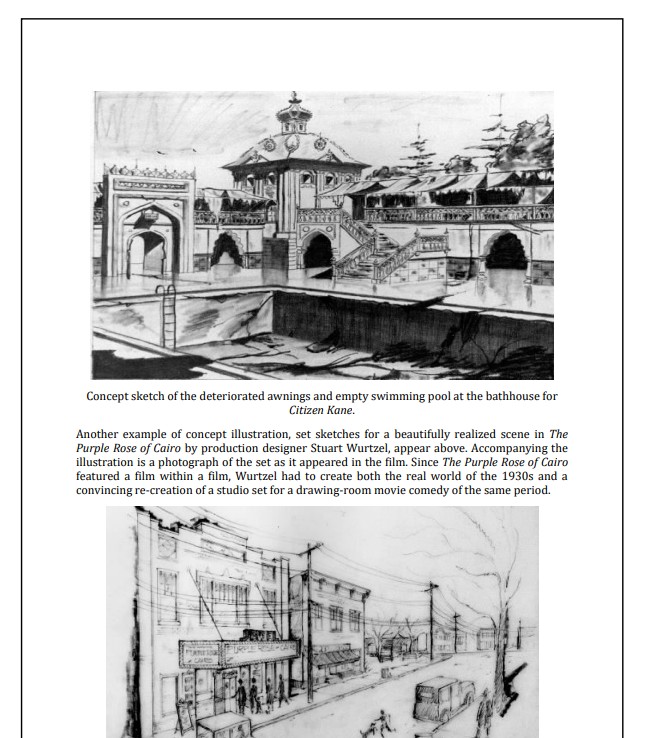
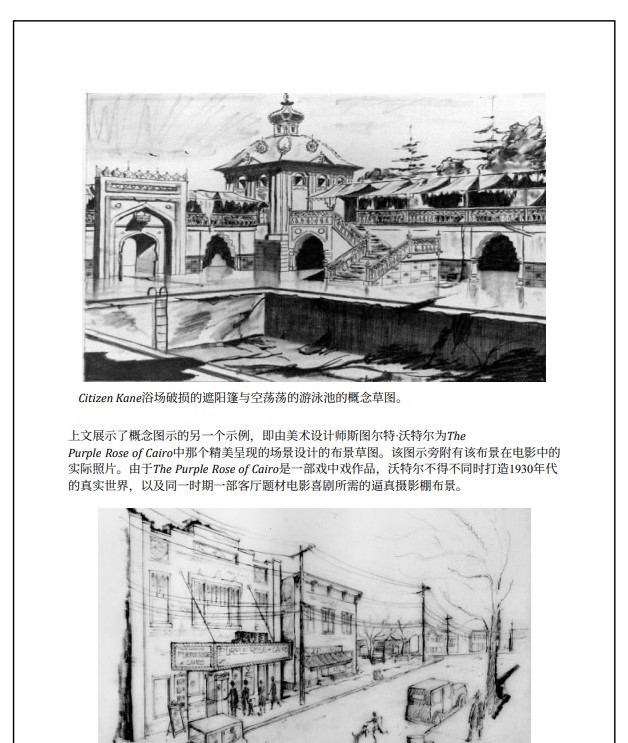
☀️月饼工坊日常☀️
🐧QB:PDFMathTranslate 是什么?
🐮AAAAA电脑高手:它是一个能保持原文版式翻译 PDF 的一个开源项目
🐧QB:这么🐮🍺?只要是 PDF 都能翻译?
🐮AAAAA电脑高手:一定要是文字版 PDF,也就是你能直接复制文字的那种。扫描版都是图片,这个项目暂时没法处理的。
🐧QB:叽里呱啦说啥呢,到底怎么用,然后开源=免费对吧?
🐮AAAAA电脑高手:有好几种使用方式,如果你的电脑有 8GB 以上显存的显卡,可以使用本地模型来翻译,需要耗费一些时间来搭建环境和运行 AI 模型来进行翻译。没有显卡也可以用在一定数量内白嫖的网站进行翻译,如果你拥有说充就充的钞能力那自然是最好的,化身尊贵的 SVIP 足以让你在这个物欲横流的资本社会节省大脑的 Token 用量。
🐧QB:哦🫥(在想午餐吃什么…)
🐮AAAAA电脑高手:总结一下——
1️⃣可白嫖、需要注册账户—— 沉浸式翻译 - BabelDOC
非会员:单次可翻译 166 页、每月 50 万 Tokens
会员(月费 ¥69 起/年费 ¥588 起;试用 3 天内可退):单次可翻译 5000 页、每月 2000 万 Tokens
2️⃣可白嫖 1-20 页翻译—— 官方免费服务
3️⃣贫穷的在线演示版本,运行的巨慢——(国外线路) 在HuggingFace上托管的演示
\ (国内线路) 在ModelScope上托管的演示
4️⃣在本地机器上运行,丰俭由人(最好有国外线路网络加速)
依赖要求 #
☀️月饼工坊日常☀️
🐧QB:啥意思?要装这东西啊?
🐮AAAAA电脑高手:是啊。不懂怎么装就问AI。
🐧QB:那我全都问 AI 不就好了,还听你在这地地地道,地地道道的😒
🐮AAAAA电脑高手:哟~可不能听 AI 瞎说啊。上一个这么说的人啊,您猜怎么着?全都问 AI 不就好了!
🐧QB:😵听君一席话,如听一席话
Step.1 安装软件包和模型 #
安装好 Python 后,打开终端并输入下面的指令,安装 PDFMathTranslate 包
pip install pdf2zh接着下载好 Ollama 并安装,根据自己机器的显卡显存来下载 Hy-MT2 翻译专用模型
下方表格内的链接是 modelscope 上托管的模型,人在国外的话优先选择在 huggingface 下载
国内线路➡️ modelscope
国外线路➡️ huggingface
GGUF 是 Ollama 能够直接导入的模型文件格式
不是这个格式的模型文件需要自己转换才可以导入,或是在 Ollama 的 模型库
里搜索下载想要的模型
| 模型规模 | 精度 | 模型文件 | 模型大小 | 推荐显存 | 下载链接 |
|---|---|---|---|---|---|
| Hy-MT2-1.8B | 1.25bit | Hy-MT2-1.8B-1.25Bit.gguf | 0.46 GB | 2 GB | Hy-MT2-1.8B-1.25bit-GGUF |
| Hy-MT2-1.8B | 2bit | Hy-MT2-1.8B-2Bit.gguf | 0.60 GB | 2 GB | Hy-MT2-1.8B-2bit-GGUF |
| Hy-MT2-1.8B | Q4_K_M | Hy-MT2-1.8B-Q4_K_M.gguf | 1.13 GB | 4 GB | Hy-MT2-1.8B-GGUF |
| Hy-MT2-1.8B | Q6_K | Hy-MT2-1.8B-Q6_K.gguf | 1.47 GB | 4 GB | Hy-MT2-1.8B-GGUF |
| Hy-MT2-1.8B | Q8_0 | Hy-MT2-1.8B-Q8_0.gguf | 1.91 GB | 6 GB | Hy-MT2-1.8B-GGUF |
| Hy-MT2-7B | Q4_K_M | Hy-MT2-7B-Q4_K_M.gguf | 4.62 GB | 8 GB | Hy-MT2-7B-GGUF |
| Hy-MT2-7B | Q6_K | HY-MT2-7B-Q6_K.gguf | 6.16 GB | 10 GB | Hy-MT2-7B-GGUF |
| Hy-MT2-7B | Q8_0 | HY-MT2-7B-Q8_0.gguf | 7.98 GB | 12 GB | Hy-MT2-7B-GGUF |
Step.2 导入模型 #
下载好模型后创建.Modelfile文件,用来自定义导入 Ollama 的模型
.Modelfile模板:
FROM 文件路径
TEMPLATE 模型提示词的模板
SYSTEM 定义模型的角色、行为、风格

PARAMETER stop <|hy_end▁of▁sentence|>
PARAMETER stop </|hy_end▁of▁sentence|>
    阻止模型输出参数到翻译内容;
PARAMETER stop <|hy_User|>
    阻止模型输出自言自语的内容;
PARAMETER stop <|hy_Assistant|>
    阻止模型输出无意义的垃圾内容。

PARAMETER temperature 0.8
	默认0.8
	控制模型回答内容的创造性/随机性。
    参数是0时完全抛弃随机性,0.1-0.4回答直奔主题,很少胡言乱语。
    0.7-0.9均衡表现,1.0-1.5开始天马行空偶尔胡编乱造。
PARAMETER seed 42
	配合 temperature 0.1 参数让模型生成的文本稳定到每次都一模一样。
PARAMETER repeat_penalty 1.1
	默认1.1
	控制模型复读的概率,重复惩罚。
    参数是1.0时让模型随意复读,1.1-1.2有效抑制模型复读的情况。
    1.3极度让模型强制排斥重复词汇并自动找补。
PARAMETER repeat_last_n 64
	默认64
	配合 repeat_penalty 参数阻止模型在一定短语内无限重复使用相同词
PARAMETER num_ctx 2048
	默认2048
	控制模型上下文的上限。根据显存设置上限,如8GB=8192,16GB=16384。
    或是根据模型支持的上下文上限设置,如qwen2.5:7b=8192,qwen3:8b=32768。
PARAMETER num_predict 128
	默认128
控制模型生成内容的上限。,-1无限,-2填满上下文以我下载的Hy-MT2-7B-Q4_K_M.gguf为例,我把文件名命名为Hy-MT2-7B-Q4_K_M.Modelfile 填入以下参数
FROM C:\Users\Downloads\Hy-MT2-7B-Q4_K_M.gguf

PARAMETER stop "<|hy_end▁of▁sentence|>"
PARAMETER stop "</|hy_end▁of▁sentence|>"
PARAMETER stop "<|hy_User|>"
PARAMETER stop "<|hy_Assistant|>"

PARAMETER temperature 0
PARAMETER seed 42
PARAMETER repeat_penalty 1.05
PARAMETER repeat_last_n 64
PARAMETER num_ctx 8192
PARAMETER num_predict 4096
这里不加 TEMPLATE 和 SYSTEM 内容,加上去效果也是微乎其微,而且在翻译文本里可能出现各种各样的奇怪参数。
如果有提示词要输入,运行脚本时额外指定一个提示词文件就可以了,我使用的提示词如下:
You are a professional technical document translation engine.
Translate the source text from ${lang_in} into ${lang_out}.

Rules:
1.Translate faithfully. Do not summarize, omit, expand, explain, or add information that is not present in the source.
2.Output only the translated text. Do not add introductions, conclusions, notes, or explanations.
3.Preserve the original order and paragraph boundaries. Do not merge separate paragraphs or split a paragraph without a clear reason.
4.Preserve all numbers, URLs, file paths, identifiers, command-line options, API names, and technical terms that should remain unchanged.
5.Preserve mathematical expressions, LaTeX, equations, variable symbols, and special markup exactly.
6.Preserve code, programming syntax, indentation, string literals, variable names, function names, and identifiers. Never rewrite code or translate code identifiers.
7.Translate natural-language comments or prose only when they can be clearly distinguished from executable code.
8.Preserve every placeholder and special marker exactly, including its spelling, capitalization, order, and count. Never remove, duplicate, translate, or modify placeholders.
9.Preserve headings, list numbering, table structure, citations, and meaningful line breaks.
10.Do not add Markdown fences, labels, or formatting that does not exist in the source.
11.Keep the translation concise and faithful. Do not add unnecessary words that may cause text expansion.
12.If a segment is code, a formula, or an ambiguous non-translatable fragment, preserve it rather than guessing.

Source text:
${text}

Translated text:
模板:
ollama create 自定义模型名 -f .Modelfile文件地址
参考:
ollama create hy-mt2-pdf:7b -f C:\Users\Downloads\hy-mt2-pdf-7b.Modelfile
Step.3 使用脚本翻译PDF #
脚本运行界面:
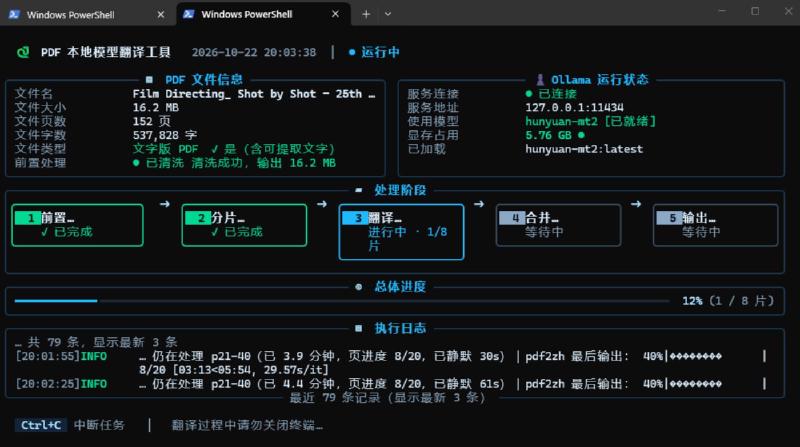
脚本文件仓库:
下载脚本并且安装好依赖环境(Python、Ollama)以后就可以开始试着翻译PDF了
C:\PyScript\translate_pdf2zh.py:脚本文件地址
C:\PyScript\test.pdf:PDF 文件地址
--model:Ollama 模型名称,我的是hy-mt2-pdf:7b
--no-skip-subset-fonts :恢复 pdf2zh 的字体子集化,减少输出文件的体积
--pages:指定翻译的页数,可以是单页数:29;也可以是范围页数:29-30。不加这个参数脚本会翻译文件里的所有页面
--prompt-file:引用单独的提示词文本
python C:\PyScript\translate_pdf2zh.py C:\PyScript\test.pdf --model hy-mt2-pdf:7b --no-skip-subset-fonts --pages 29 --prompt-file C:\Users\Documents\PyScript\prompt.txt脚本默认会在 PDF 文件夹创建一个output,翻译文件和日志都会存放在里面
可以使用--out-dir 参数来指定输出文件夹
更多脚本使用示例:
# 最简:整本翻译,模型用默认值
python translate_pdf2zh.py "book.pdf"

# 指定模型(不指定时:TTY 下交互选择已装模型)
python translate_pdf2zh.py "book.pdf" --model Hy-MT2

# 只自检不翻译:查 PDF 页数 / Ollama 服务与模型 / pdf2zh 是否可用
python translate_pdf2zh.py "book.pdf" --model Hy-MT2 --dry-run

# 只译前 5 页验质量,看版式与术语是否正常
python translate_pdf2zh.py "book.pdf" --model Hy-MT2 --probe-only

# 只译指定页范围(可多段,逗号分隔,越界部分自动裁掉)
python translate_pdf2zh.py "book.pdf" --pages 1-50
python translate_pdf2zh.py "book.pdf" --pages 1-5,20-30

# 非交互环境 / 重定向输出到文件时手动关面板,用普通滚动日志
python translate_pdf2zh.py "book.pdf" --model Hy-MT2 --plain > run.log 2>&1

# 调参:分片页数 / 单片超时 / 模型常驻时长 / 输出目录 / 保留分片 / 失败即停
python translate_pdf2zh.py "book.pdf" --model Hy-MT2 \
    --pages-per-chunk 10 --timeout 1800 --keep-alive 10m \
    --out-dir ./out --keep-chunks --stop-on-error

# 指定源语言与目标语言(默认英译中;也可写全称或中文)
python translate_pdf2zh.py "book.pdf" --src-lang English --dst-lang 中文

# 自定义翻译提示词(UTF-8,可含 ${lang_in} / ${lang_out} / ${text} 占位符)
python translate_pdf2zh.py "book.pdf" --prompt-file my_prompt.txt
记录在案问题 #
缓存问题 #
Q: 我重新编写了模型的
.Modelfile文件,并且重构了 Ollama 的模型,但是翻译出来的内容为什么没有区别?
A: pdf2zh 会在用户目录下(
C:\Users\username\.cache\pdf2zh)生成一个cache.v1的缓存,重构或是更换模型发现内容没有变化,可以把这个缓存文件删掉再试试
脚本进度停滞不前 #
Q: 等了好久脚本都没有动静。日志还叫我自己去查 Ollama 是不是爆显存了,但是我查了下显存并没有爆啊。
A: 可以在 PDF 输出目录下的
output\chunks\translate_logs找到最新一个日志文件,根据日志内容排除问题根源。
依赖缺失 #
ImportError: cannot import name 'TextTranslateRequest' from 'tencentcloud.tmt.v20180321.models'首次运行程序出现以上错误是因为腾讯云的 SDK 在 3.1.121 和 3.1.129 版本之间移除了TextTranslateRequest/TextTranslateResponse 类,可以通过锁定可用的包版本解决这个问题
# 先卸载现有版本
pip uninstall tencentcloud-sdk-python
# 接着安装可用版本
pip install tencentcloud-sdk-python==3.0.1257
解决方案来自: # tencentcloud-sdk-python-tmt 未固定依赖项导致导入失败(TextTranslateRequest 已在 3.1.x 版本中移除)